Лид: Рабочий процесс разработки с нейросетью: постановка задачи, контекст, итерации, тесты, ревью и безопасность.
Чтобы писать код с нейросетью без критических ошибок, нужно каждый сгенерированный фрагмент проверять автоматическими тестами, ревью и контролем версий, не выдавать модели избыточные права, логировать все действия и помнить, что вывод LLM нельзя считать доверенным.
Почему нейросети ошибаются в коде
Языковые модели обучены предсказывать следующий токен на основе статистики текстов, а не понимать логику программы. Они могут воспроизвести синтаксически корректный код, который выглядит правдоподобно, но содержит логическую ошибку, устаревший API или несуществующую библиотеку. Модель не компилирует и не запускает результат до выдачи, поэтому не знает, работает ли предложенный код в реальности.
Кроме того, нейросеть не имеет контекста всего проекта — она видит только тот фрагмент кода и текста, который находится в окне запроса. Если в инструкции не указать используемую версию фреймворка, зависимости или архитектурные соглашения, модель может предложить решение, несовместимое с остальной кодовой базой.
Проект OWASP Top 10 для LLM-приложений выделяет риски, связанные с использованием языковых моделей: prompt injection, раскрытие чувствительной информации, небезопасная обработка вывода и избыточная автономность. Эти угрозы актуальны и при генерации кода, особенно если модель имеет доступ к репозиторию или командной строке.
Выбор инструмента для совместной работы с ИИ
Для генерации кода используются плагины в редакторе, интерфейсы чата, терминальные клиенты и специализированные SDK. Выбор зависит от того, насколько тесно вы хотите интегрировать модель в рабочий процесс и какими правами она должна обладать.
Плагины в IDE предлагают автодополнение и ответы на вопросы прямо в редакторе. Они не получают доступ к файловой системе за пределами открытого проекта и не выполняют команды от вашего имени. Это безопаснее, но требует вручную копировать код и контролировать каждый шаг.
Терминальные клиенты, такие как OpenAI Codex CLI, могут читать, изменять и запускать код в пределах выданных разрешений. Изменения нужно проверять через тесты и контроль версий. Такой подход ускоряет итерации, но требует осторожной настройки прав и логирования всех действий.
SDK и API-вызовы дают полный контроль над контекстом и форматом ответа. Вы можете встроить вызов модели в пайплайн CI/CD, скрипт рефакторинга или инструмент документирования. При этом вы сами отвечаете за валидацию ввода, обработку ошибок и защиту от injection.
Критерии выбора инструмента
- Какие права доступа к файловой системе и командам нужны модели для решения задачи.
- Можно ли ограничить модель только чтением или требуется запись и выполнение.
- Как будет организовано логирование запросов, ответов и совершённых действий.
- Поддерживает ли инструмент интеграцию с системой контроля версий и автотестами.
- Можно ли передать модели дополнительный контекст проекта — конфигурацию, зависимости, документацию.
Постановка задачи и подготовка контекста
Качество сгенерированного кода напрямую зависит от того, насколько точно вы описали задачу и какой контекст предоставили. Общая формулировка «напиши функцию для обработки данных» приведёт к общему и часто нерабочему результату. Конкретная инструкция с примером входных и выходных данных, указанием используемых библиотек и ограничений даст более точный код.
В запрос стоит включить:
- Язык программирования и версию (например, Python 3.11).
- Используемые фреймворки и библиотеки с версиями.
- Формат входных данных и ожидаемый результат.
- Ограничения: производительность, потребление памяти, совместимость.
- Стиль кодирования: наличие типов, обработка ошибок, структура.
Если проект использует определённые паттерны или архитектурные соглашения, добавьте пример существующего кода или ссылку на внутренний гайд. Это поможет модели генерировать код, который органично впишется в кодовую базу.
Пример структурированного запроса
Напиши функцию на Python 3.11 с использованием библиотеки pydantic для валидации JSON-конфига.
Входные данные: строка JSON с полями "api_key", "timeout" (целое число) и "retries" (целое число).
Ожидаемый результат: объект класса Config с валидированными полями или выброс ValidationError.
Обязательно использовать type hints и обрабатывать случай невалидного JSON.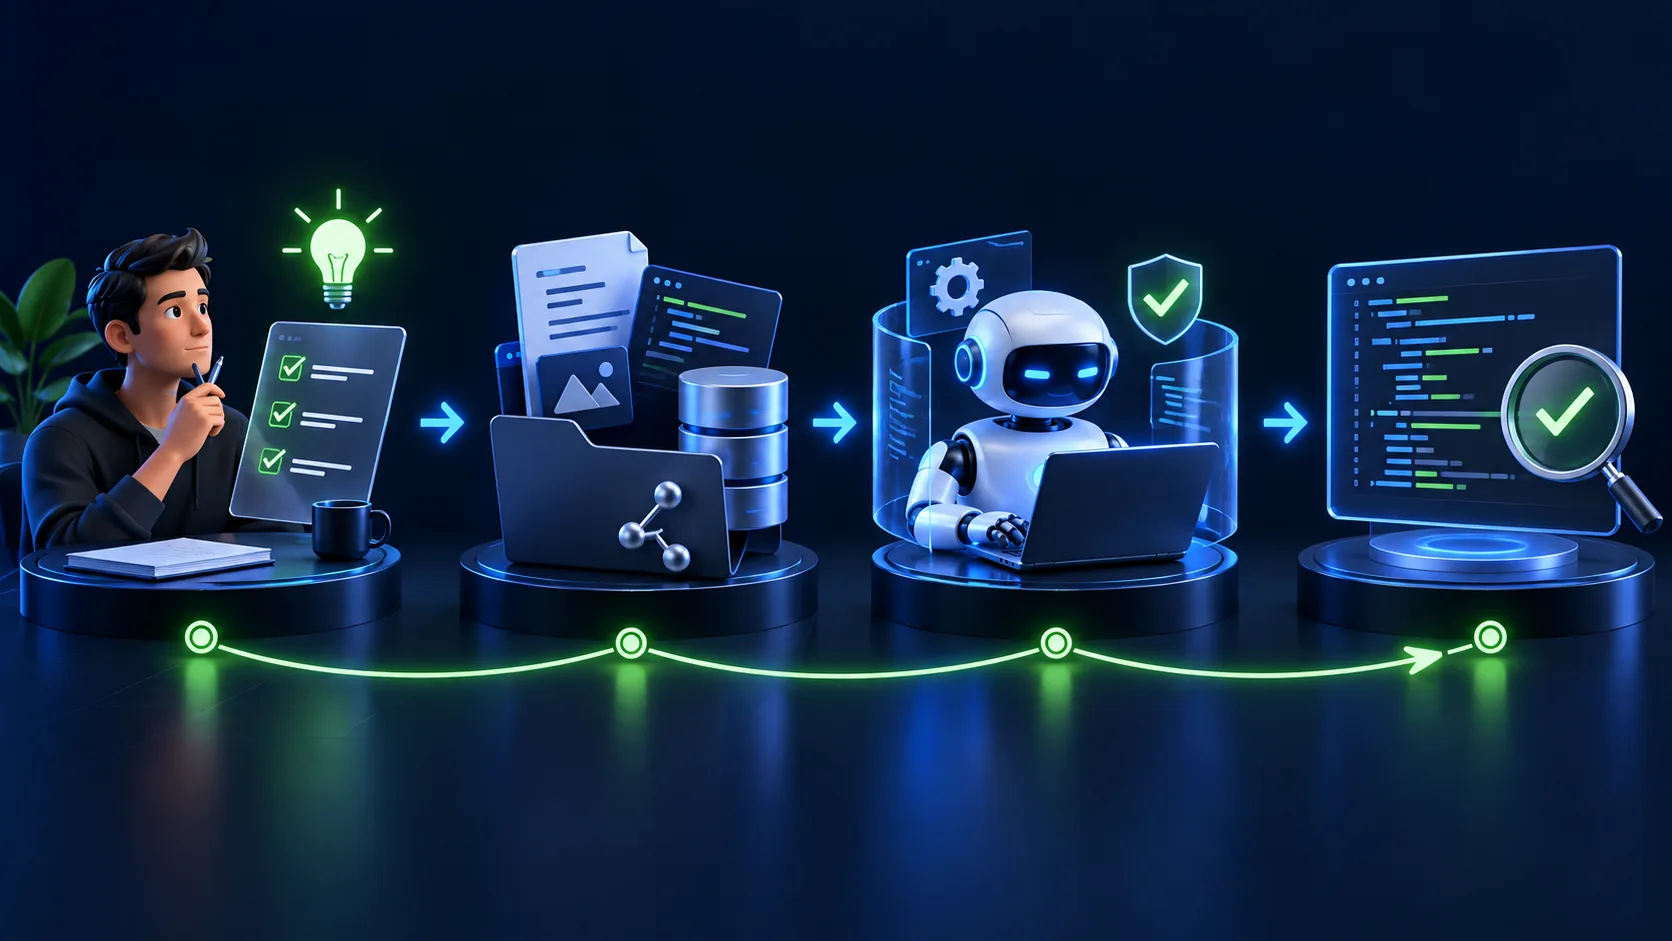
Итеративная доработка и уточнение кода
Первая версия кода редко работает сразу. Вместо того чтобы переписывать весь фрагмент, уточните запрос, добавив информацию об ошибке, тесте или требовании, которое не выполнено. Модель может доработать код, если вы укажете на конкретную проблему.
Если сгенерированная функция не проходит тест, скопируйте вывод теста в новый запрос и попросите исправить. Если код работает, но не соответствует стилю проекта, добавьте пример желаемого стиля. Если производительность неудовлетворительна, уточните метрики и ограничения.
Итеративный подход помогает модели учесть нюансы, которые сложно описать в одном запросе. Каждый цикл уточнения делает результат ближе к требованиям проекта.
Пример итерации
- Первый запрос: «Напиши функцию для парсинга CSV с полями name, age, email».
- Модель возвращает код, который не обрабатывает пустые строки.
- Второй запрос: «Дополни функцию проверкой на пустые строки и логированием ошибок парсинга».
- Модель добавляет проверку и логирование.
- Третий запрос: «Переделай в генератор для обработки больших файлов».
- Модель переписывает функцию с использованием
yield.
Автоматические тесты как первая линия защиты
Любой код, сгенерированный нейросетью, должен проходить через автоматические тесты перед попаданием в основную ветку. Тесты проверяют не только корректность логики, но и граничные случаи, обработку ошибок и совместимость с остальной системой.
Если у вас уже есть набор unit-тестов для модуля, который вы дополняете или рефакторите, запустите их сразу после вставки сгенерированного кода. Если тесты падают, передайте вывод модели и попросите исправить. Если тестов нет, напишите их перед интеграцией кода — это дополнительная страховка от регрессий.
Покрытие тестами особенно важно для кода, который работает с внешними данными, API или файловой системой. Модель может сгенерировать код, который работает на примерах, но падает на реальных данных с неожиданными форматами или размерами.
Типы тестов для сгенерированного кода
- Unit-тесты: проверяют отдельные функции и методы на корректность результата и обработку исключений.
- Интеграционные тесты: проверяют взаимодействие сгенерированного кода с остальными модулями и внешними системами.
- Тесты на граничные случаи: пустые входные данные, очень большие значения, невалидные форматы.
- Тесты производительности: проверяют, что новый код не вносит существенных задержек или утечек памяти.
Ревью кода и контроль версий
Код, сгенерированный нейросетью, проходит через тот же процесс ревью, что и код, написанный человеком. В процессе ревью коллега проверяет читаемость, соответствие стандартам проекта, наличие комментариев и документации, а также выявляет потенциальные уязвимости.
Контроль версий позволяет откатить изменения, если сгенерированный код вызовет проблемы в продакшене. Используйте отдельные ветки для экспериментов с моделью, чтобы не загрязнять основную ветку нестабильными изменениями. Коммиты с кодом от нейросети стоит маркировать, чтобы в будущем можно было отследить происхождение фрагмента.
Ревьюер должен обратить внимание на:
- Правильность обработки ошибок и исключений.
- Отсутствие хардкода секретов, путей или временных значений.
- Соответствие переменных и функций соглашениям о наименовании.
- Наличие комментариев в сложных местах.
- Использование актуальных API и зависимостей.
Типичные ошибки при работе с нейросетями
Разработчики часто доверяют сгенерированному коду больше, чем следует, особенно если он выглядит правдоподобно и работает на первом примере. Это приводит к пропуску логических ошибок, уязвимостей и несовместимости с остальной системой.
Несуществующие библиотеки и функции
Модель может предложить импорт библиотеки или вызов функции, которых не существует. Это происходит потому, что модель обучена на текстах, а не на актуальной документации. Перед использованием кода проверьте, что все импорты действительно доступны в вашем окружении.
Устаревшие API и синтаксис
Если модель обучена на данных до определённой даты, она может предложить синтаксис или API, которые устарели в новых версиях языка или библиотеки. Всегда сверяйте сгенерированный код с актуальной документацией.
Отсутствие обработки ошибок
Модель часто генерирует «счастливый путь» — код, который работает при идеальных входных данных. Обработка исключений, проверка на None, валидация форматов остаются на совести разработчика. Дополните сгенерированный код обработкой ошибок перед использованием.
Хардкод секретов и временных значений
Модель может вставить в пример секреты, пути к файлам или тестовые значения, которые нельзя коммитить в репозиторий. Всегда проверяйте код на наличие хардкода и заменяйте его на переменные окружения или конфигурационные файлы.
Избыточная сложность
Иногда модель предлагает излишне сложное решение, когда существует простое и стандартное. Если сгенерированный код трудно понять или поддерживать, попросите модель упростить или найдите готовое решение в документации.
Безопасность при использовании нейросетей в разработке
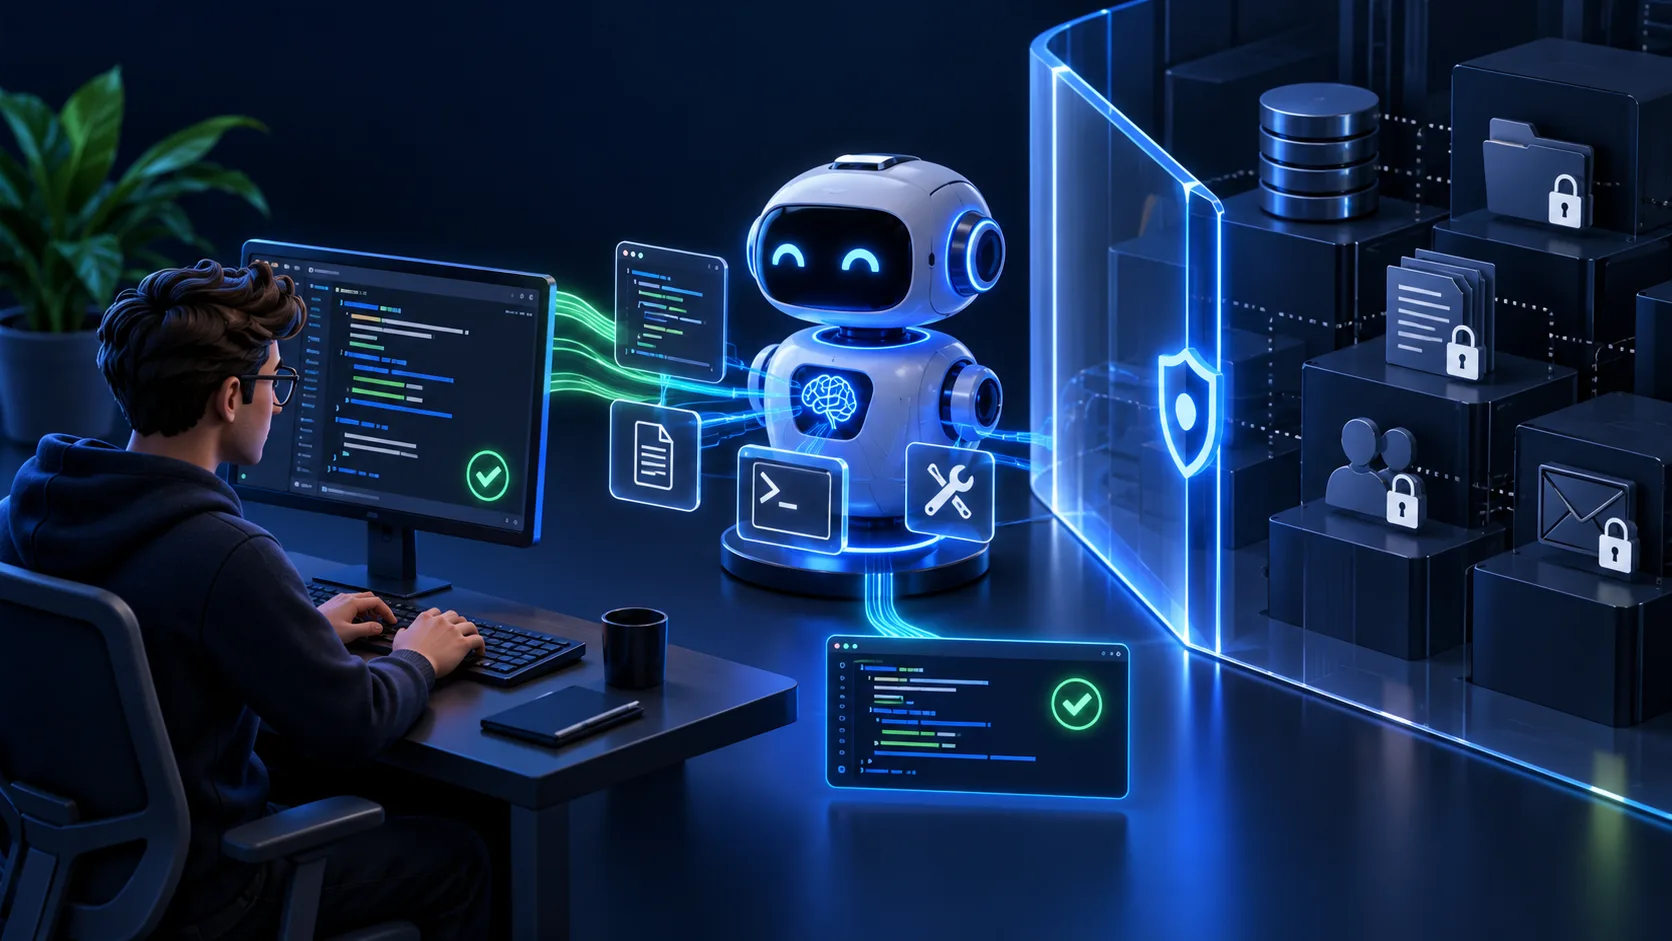
Работа с нейросетями требует дополнительных мер безопасности, особенно если модель имеет доступ к репозиторию, командной строке или внешним системам. Проект OWASP Top 10 для LLM-приложений предупреждает, что вывод модели нельзя считать доверенным вводом для привилегированных действий.
Ограничение прав доступа
Если вы используете терминального клиента или SDK, выдайте модели минимально необходимые права. Например, доступ только на чтение к репозиторию и отдельная песочница для выполнения кода. Избыточная автономность — одна из ключевых угроз, выделенных OWASP.
Логирование всех действий
Все запросы к модели, её ответы и совершённые изменения в коде должны логироваться. Это позволяет отследить происхождение ошибки или уязвимости, а также обеспечивает аудит для соответствия стандартам безопасности.
Защита от prompt injection
Если модель работает с внешними данными (например, парсит пользовательский ввод или документацию), злоумышленник может внедрить инструкцию, которая изменит поведение модели. Валидируйте и санитизируйте все данные, попадающие в контекст модели.
Контроль за чувствительной информацией
Не передавайте модели секреты, токены доступа, персональные данные или внутренние архитектурные детали, если это не абсолютно необходимо. Модель может случайно воспроизвести эту информацию в ответе или использовать её в обучающих данных провайдера, если это разрешено условиями использования.
Управление рисками ИИ
Фреймворк NIST AI Risk Management Framework предлагает добровольный подход к управлению рисками ИИ на этапах проектирования, разработки, использования и оценки. Профиль генеративного ИИ предлагает действия по функциям govern, map, measure и manage, которые помогают организовать процесс работы с моделями безопасно и прозрачно.
Чек-лист проверки кода от нейросети
Перед интеграцией сгенерированного кода в проект пройдитесь по этому списку:
| Пункт проверки | Что проверять |
|---|---|
| Синтаксис и импорты | Код компилируется, все библиотеки установлены и доступны. |
| Логика и корректность | Функция решает заявленную задачу, проходит unit-тесты. |
| Граничные случаи | Пустые данные, большие значения, невалидные форматы обрабатываются. |
| Обработка ошибок | Исключения перехватываются, логируются или пробрасываются корректно. |
| Секреты и хардкод | Нет токенов, путей, паролей или временных значений. |
| Стиль кода | Имена переменных и функций соответствуют стандартам проекта. |
| Документация | Комментарии и docstrings объясняют неочевидные места. |
| Производительность | Нет очевидных узких мест, утечек памяти или избыточных операций. |
| Безопасность | Нет SQL-инъекций, path traversal, небезопасной десериализации. |
| Совместимость | Код работает с актуальными версиями зависимостей и окружения. |
Интеграция нейросети в пайплайн разработки
Чтобы нейросеть стала постоянным инструментом, а не разовым экспериментом, встройте её в рабочий процесс команды. Определите, на каких этапах модель приносит максимальную пользу, и автоматизируйте эти этапы.
Нейросеть может генерировать шаблоны функций по документации, предлагать варианты рефакторинга, писать unit-тесты для существующего кода, создавать docstrings или переводить код с одного языка на другой. Каждый из этих сценариев требует своей настройки контекста, валидации результата и интеграции в CI/CD.
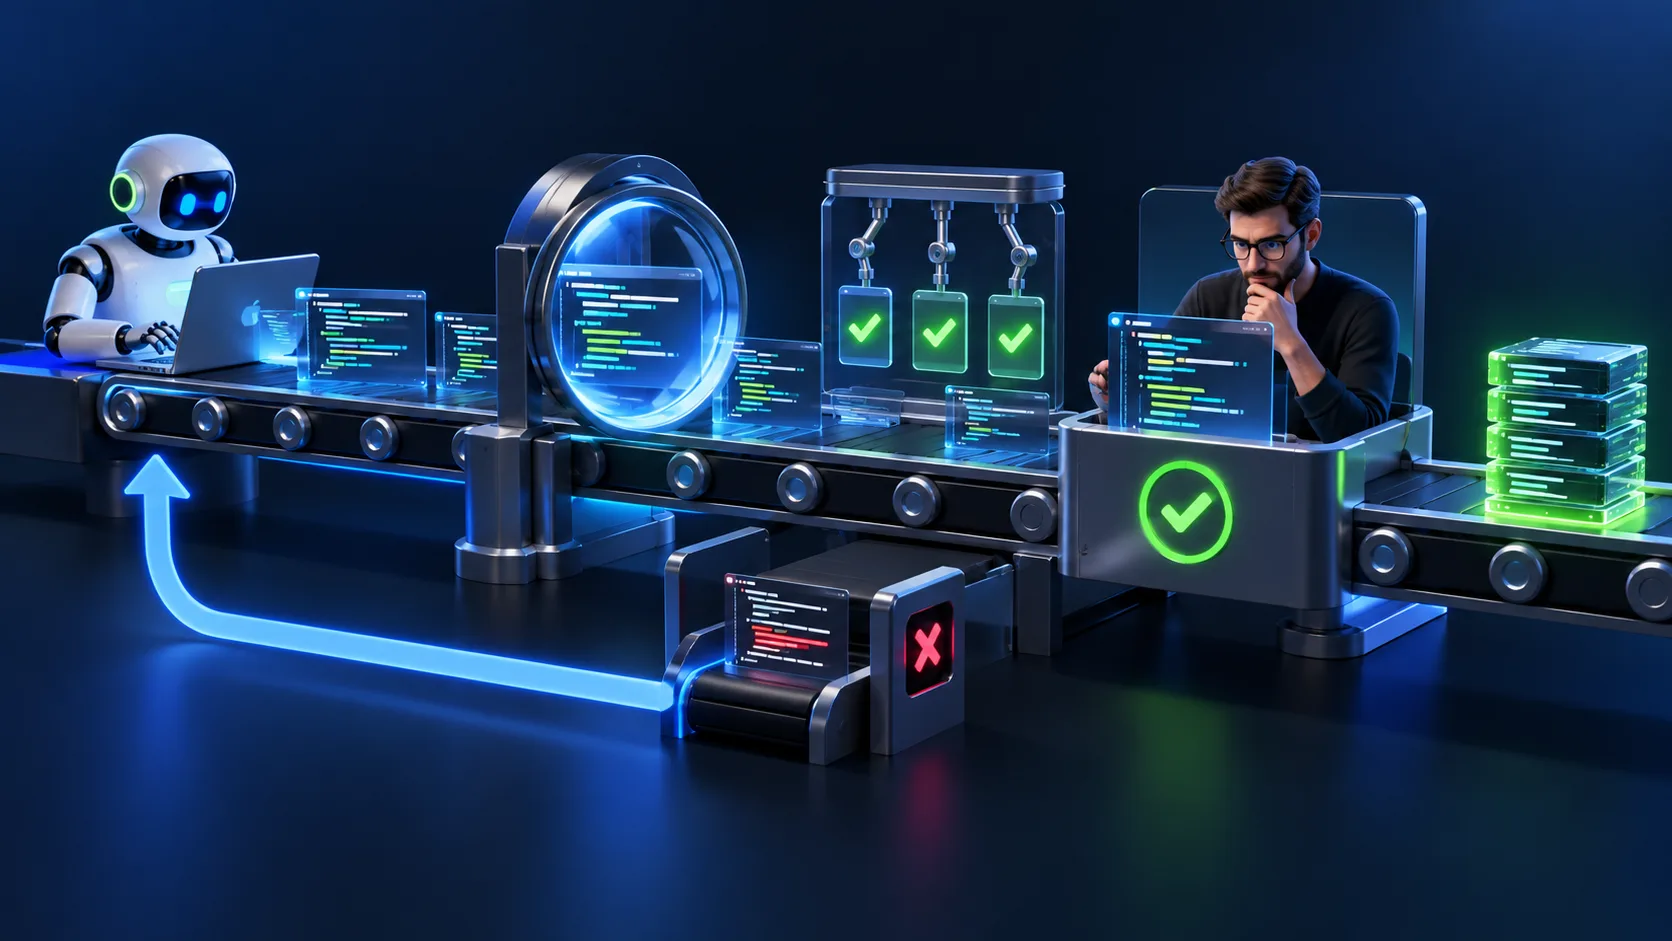
Например, если вы используете модель для генерации тестов, настройте скрипт, который берёт функцию из репозитория, передаёт её модели с инструкцией написать тесты, запускает сгенерированные тесты и, если они проходят, создаёт pull request для ревью. Это экономит время на рутинных задачах и позволяет команде сосредоточиться на архитектуре и бизнес-логике.
Пример интеграции в CI/CD
- Разработчик отправляет pull request с новой функцией.
- CI запускает скрипт, который вызывает модель с запросом сгенерировать тесты для этой функции.
- Сгенерированные тесты запускаются автоматически.
- Если тесты проходят, они добавляются в отдельный коммит для ревью.
- Ревьюер проверяет и функцию, и тесты перед мержем.
Частые вопросы
Можно ли полностью доверять коду от нейросети?
Нет. Языковая модель генерирует правдоподобный код на основе статистики, но не гарантирует корректности логики, безопасности или совместимости. Каждый фрагмент нужно проверять тестами, ревью и запуском.
Как защитить секреты при работе с моделью?
Не передавайте секреты в контекст запроса. Если модель требует примеры конфигурации, используйте заглушки. Всегда проверяйте сгенерированный код на наличие хардкода секретов перед коммитом.
Нужно ли писать тесты для кода от нейросети?
Да. Автоматические тесты — единственный надёжный способ проверить, что сгенерированный код работает корректно и не сломает существующую функциональность. Если у вас нет тестов, напишите их перед интеграцией кода.
Как часто нейросеть предлагает несуществующие функции?
Это зависит от модели и актуальности её обучающих данных. Модели, обучённые на старых данных, чаще предлагают устаревшие API. Всегда сверяйте импорты и вызовы функций с официальной документацией.
Можно ли использовать нейросеть для рефакторинга legacy-кода?
Да, но с осторожностью. Модель может предложить современный синтаксис и улучшить читаемость, но не понимает бизнес-логику и граничные случаи. После рефакторинга запустите все регрессионные тесты и проведите тщательное ревью.
Как документировать код, сгенерированный нейросетью?
Добавьте комментарии, объясняющие назначение функции и неочевидные решения. Укажите в коммите или pull request, что код сгенерирован моделью, чтобы будущие разработчики понимали его происхождение. Используйте docstrings для публичных функций.
Какие права нужно выдавать модели для работы с репозиторием?
Минимально необходимые. Если модель только читает код и предлагает изменения, достаточно read-only доступа. Если она записывает файлы, ограничьте её отдельной папкой или песочницей. Никогда не выдавайте права на выполнение произвольных команд без логирования и ограничений.
Как проверить, что модель не внедрила уязвимость?
Используйте статические анализаторы безопасности (SAST), dependency checkers и ревью кода. Проверьте, что модель не создаёт SQL-инъекций, не десериализует недоверенные данные и не использует небезопасные функции. Логируйте все изменения для аудита.
Практический вывод
Нейросети ускоряют генерацию кода, но не заменяют профессиональную проверку. Чтобы не пропускать критические ошибки, встраивайте модель в процесс разработки как инструмент, а не как автономного разработчика. Ограничивайте права, логируйте действия, проверяйте результат автотестами и ревью, контролируйте версии и помните, что вывод LLM не является доверенным. Только так нейросеть станет полезным помощником, а не источником новых проблем.