Лид: Безопасная работа с документами: извлечение фактов, сравнение версий, подготовка черновиков и защита конфиденциальных данных.
Дата проверки продуктовых сведений: 2026-09-16
Нейросеть может извлекать факты из документов, составлять черновики и сравнивать версии текстов. Чтобы работа была полезной, нужно чётко сформулировать задачу, проверить вывод на контрольных примерах и защитить конфиденциальные данные на всех этапах. В этом материале рассматриваются типовые рабочие процессы, проверка качества и меры безопасности для документооборота с участием языковых моделей.
Что нейросеть умеет делать с документами
Современные языковые модели обрабатывают текст, таблицы и структурированные данные. Основные сценарии применения включают извлечение фактов из договоров, протоколов и отчётов, сравнение редакций документа для поиска изменений, подготовку черновиков писем и резюме, а также классификацию входящих документов по типу или теме.
Модель работает с текстом, который вы передаёте в запросе. Она не имеет прямого доступа к файловой системе или базам данных, пока вы не встроите такой доступ через код. Для получения результата нужно явно указать текст документа или его фрагменты, сформулировать задачу и задать формат вывода.
Важно понимать, что модель анализирует переданный контекст, но не проверяет факты в независимых источниках. Поэтому вывод всегда требует проверки человеком, особенно если результат будет использоваться для принятия решений или публикации.
Выбор инструмента и способа интеграции
Для работы с документами подходят облачные API языковых моделей, локальные модели и готовые решения с интерфейсом. Облачные API позволяют быстро начать, но передают данные за пределы вашей инфраструктуры. Локальные модели сохраняют данные внутри периметра, но требуют вычислительных ресурсов и настройки окружения.
При выборе инструмента учитывайте классификацию данных, с которыми будет работать модель. Если документы содержат персональные данные, коммерческую тайну или конфиденциальную информацию клиентов, облачный API допустим только при наличии соглашения об обработке данных и гарантий, что ваши запросы не используются для обучения модели.
Для интеграции в существующий процесс документооборота удобно создать промежуточный сервис, который принимает документ, вызывает модель с заранее отработанной инструкцией, проверяет формат вывода и возвращает результат. Такой сервис упрощает контроль версий инструкций, журналирование запросов и управление квотами.
Подготовка инструкции для модели
Качество работы модели зависит от чёткости инструкции. Согласно рекомендациям OpenAI по разработке промптов, инструкции должны ясно задавать задачу, контекст, ограничения и ожидаемый формат. Например, вместо общего «проанализируй договор» лучше написать: «Из текста договора извлеки название сторон, дату заключения, предмет договора и срок действия. Верни результат в виде JSON с ключами parties, date, subject, term. Если какое-то поле не найдено, укажи null».
Инструкция состоит из нескольких элементов: роли модели, описания задачи, примера входных данных, примера ожидаемого вывода, ограничений и формата ответа. Роль помогает модели настроиться на нужный стиль: «Ты помощник юриста» или «Ты редактор технических документов». Задача должна быть конкретной и измеримой. Пример показывает модели желаемую структуру. Ограничения предотвращают нежелательное поведение: «Не добавляй информацию, которой нет в тексте», «Не интерпретируй намерения сторон».
Формат вывода задают явно: JSON, таблица, маркированный список или строго структурированный текст. Это упрощает автоматическую обработку ответа и снижает риск ошибок парсинга.
Пример инструкции для извлечения данных из договора
Роль: Ты помощник юриста, извлекающий ключевые данные из договоров.
Задача: Из текста договора извлеки следующие поля:
- parties: массив строк с названиями сторон
- date: дата заключения в формате YYYY-MM-DD
- subject: краткий предмет договора одним предложением
- term: срок действия договора

Ограничения:
- Используй только информацию из текста договора.
- Не интерпретируй и не дополняй данные.
- Если поле не найдено, верни null.

Формат: JSON с указанными ключами.

Текст договора:
{document_text}
Рабочий процесс анализа документа
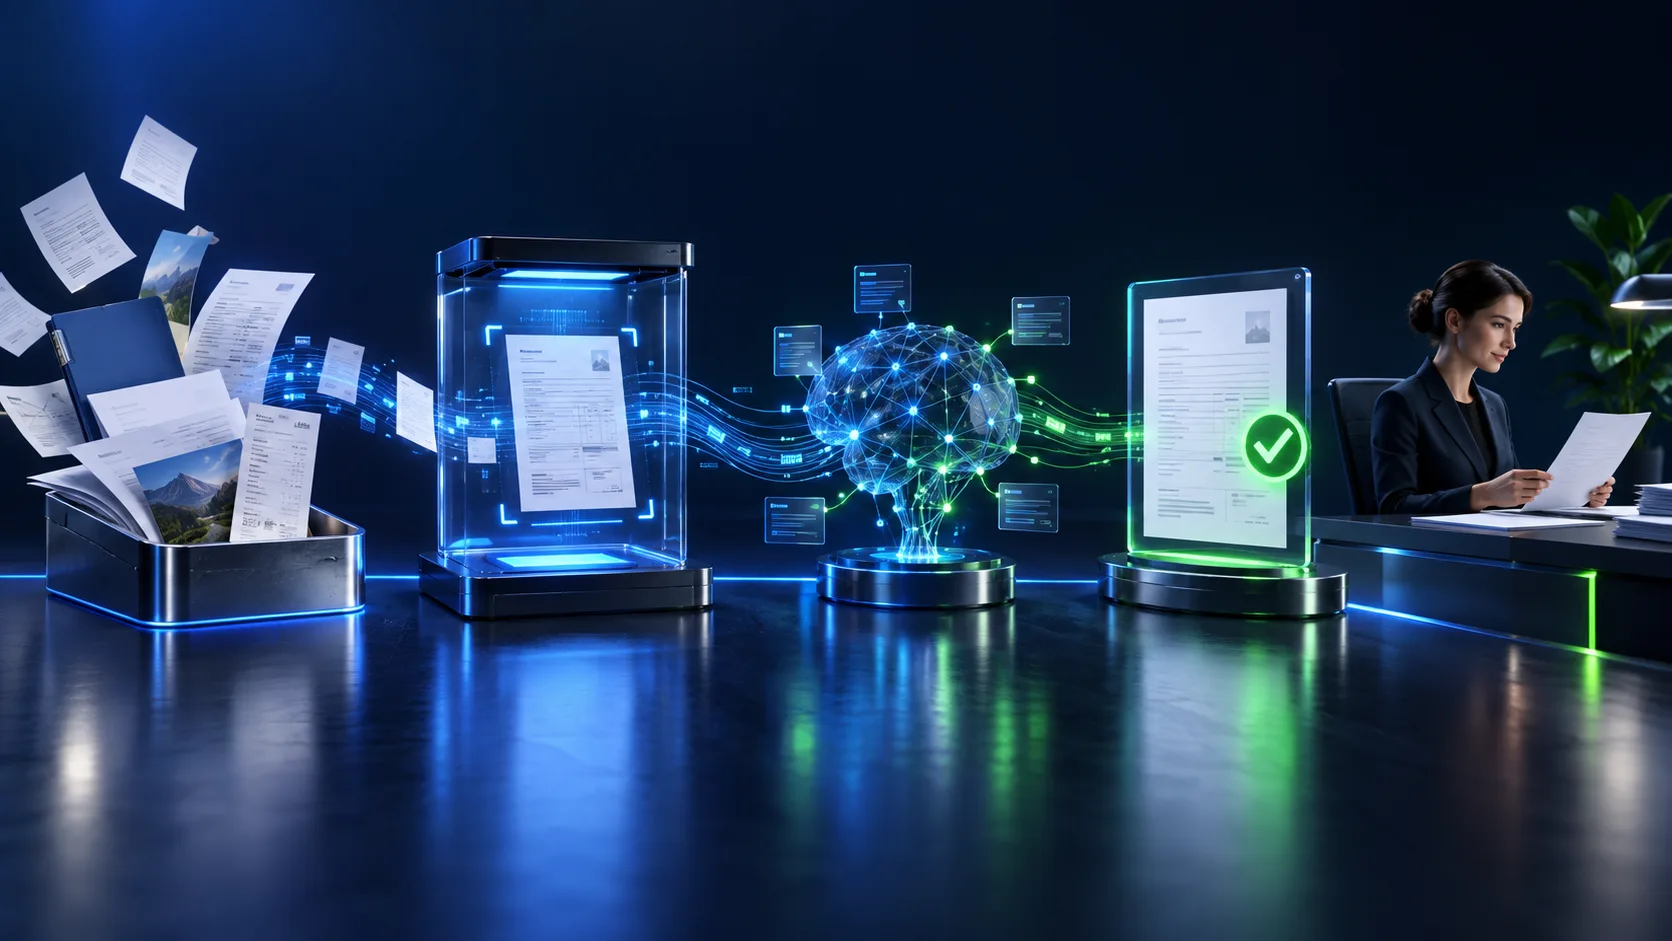
Типовой процесс анализа включает несколько этапов. Сначала документ преобразуется в текст. Если исходный файл в формате PDF, DOCX или изображение, потребуется конвертер или OCR-сервис. Далее текст передаётся модели вместе с инструкцией. Модель возвращает структурированный вывод. Затем вывод проверяется на соответствие ожидаемому формату: парсится JSON, проверяется наличие обязательных полей. Если формат нарушен, запрос можно повторить с уточнением.
После валидации формата результат проверяет человек. Для ответственных задач — юридических, финансовых, кадровых — автоматический вывод не должен применяться напрямую. Проверяющий сравнивает извлечённые данные с исходным текстом, исправляет ошибки и подтверждает корректность интерпретации.
Все шаги стоит журналировать: сохранять текст запроса, ответ модели, время обработки и идентификатор документа. Журнал помогает анализировать типичные ошибки, настраивать инструкции и отслеживать случаи некорректного вывода.
Сравнение версий документов
Языковая модель может помочь выявить изменения между двумя версиями текста. Для этого в запрос передают обе версии и просят описать различия. Инструкция должна задавать, какие изменения важны: добавление или удаление предложений, изменение ключевых терминов, изменение дат, сумм или имён.
Например: «Сравни две версии договора. Укажи, какие пункты добавлены, какие удалены, какие изменены. Для изменённых пунктов покажи старое и новое значение. Верни результат в виде списка изменений с указанием раздела документа».
Этот подход удобен для предварительного анализа, но не заменяет специализированные инструменты сравнения документов, которые показывают изменения на уровне символов и позволяют принять или отклонить правки. Модель работает на уровне смысла, а не форматирования, поэтому может пропустить незначительные правки пунктуации или порядка слов.
Подготовка черновиков и резюме
Модель может составить черновик письма, резюме многостраничного отчёта или краткую выжимку из протокола встречи. Чтобы черновик был полезен, в инструкции нужно указать целевую аудиторию, тон текста, объём и обязательные пункты.
Например, для резюме отчёта: «Составь резюме отчёта объёмом не более 200 слов. Включи основные выводы, ключевые показатели и рекомендации. Используй деловой стиль. Не добавляй информацию, которой нет в отчёте».
Черновик всегда требует редактуры. Модель может упустить нюансы, важные для вашей аудитории, или сформулировать мысль двусмысленно. Редактор проверяет фактическую точность, уместность формулировок и соответствие корпоративному стилю.
Проверка качества вывода
Согласно рекомендациям OpenAI, качество проверяют на наборе примеров, а не по одному удачному ответу. Соберите контрольный набор документов с заранее известными правильными ответами. Пропустите каждый документ через модель и сравните вывод с эталоном. Посчитайте, в скольких случаях модель извлекла все обязательные поля, в скольких допустила ошибку или пропустила информацию.
Для задач извлечения данных удобно считать точность по каждому полю: процент документов, в которых поле извлечено правильно. Для задач сравнения и резюмирования точность измеряется сложнее, часто требуется экспертная оценка нескольких проверяющих.
Если модель систематически ошибается на определённом типе документов или полей, пересмотрите инструкцию: добавьте примеры, уточните формулировки, укажите явные ограничения. Итеративное улучшение инструкции на основе анализа ошибок — основной способ повысить качество.
Типичные ошибки и способы их избежать
Языковые модели могут добавлять информацию, которой нет в исходном тексте. Это называется галлюцинацией. Чтобы снизить риск, явно укажите в инструкции: «Не добавляй данные, которых нет в документе. Если информация отсутствует, верни null или оставь поле пустым».
Модель может неправильно интерпретировать контекст, особенно если документ содержит юридические или технические термины с неоднозначным значением. Для минимизации таких ошибок передавайте в запрос определения ключевых терминов или примеры правильной интерпретации.
Длинные документы могут не помещаться в контекст модели. В таком случае разделите документ на фрагменты, обработайте каждый отдельно и объедините результаты. Убедитесь, что деление не разрывает связанные пункты, иначе модель потеряет контекст.
Неструктурированный вывод затрудняет автоматическую обработку. Всегда задавайте формат явно и проверяйте, что модель его соблюдает. Если вывод не парсится, отправьте запрос повторно или добавьте в инструкцию пример правильного формата.
Безопасность и защита конфиденциальных данных
Работа с документами часто связана с обработкой конфиденциальной информации. Согласно OWASP Top 10 для приложений с LLM, существенные риски включают раскрытие чувствительной информации, небезопасную обработку вывода и избыточную автономность модели.
Перед отправкой документа в модель оцените его классификацию. Если документ содержит персональные данные, коммерческую тайну или данные, подпадающие под регуляторные требования, используйте локальную модель или облачный сервис с соглашением об обработке данных и гарантией, что данные не покидают указанный регион и не используются для обучения.
Рассмотрите предварительную анонимизацию: замените имена, адреса, номера телефонов и другие персональные идентификаторы на заглушки перед отправкой в модель. После получения ответа восстановите оригинальные значения. Этот подход снижает риск утечки, но требует надёжного механизма замены и восстановления.
Вывод модели нельзя считать доверенным вводом для привилегированных действий. Согласно рекомендациям OWASP, вывод модели нельзя считать доверенным вводом для привилегированных действий. Если модель генерирует команду, SQL-запрос или вызов API, проверьте и санитизируйте вывод перед исполнением. Ограничивайте права сервиса, который выполняет действия по результатам вывода модели, до минимально необходимых.
Управление рисками при использовании ИИ для документов
Подход к управлению рисками описан в NIST AI Risk Management Framework. Фреймворк предназначен для добровольного управления рисками ИИ на этапах проектирования, разработки, использования и оценки. Профиль генеративного ИИ предлагает действия по функциям govern, map, measure и manage.
Для документооборота это означает: определите, кто отвечает за качество и безопасность вывода модели; составьте карту рисков с учётом типа обрабатываемых данных и последствий ошибки; установите метрики качества и регулярно проверяйте модель на контрольных примерах; внедрите процедуры реагирования на инциденты, связанные с некорректным выводом или утечкой данных.
Документируйте решения: почему выбрана та или иная модель, какие инструкции используются, как проверяется вывод, кто и когда проводит аудит. Документация упрощает передачу знаний внутри команды и помогает при аудите со стороны регуляторов или внутреннего контроля.
Чек-лист для внедрения нейросети в работу с документами
- Определите задачу: извлечение данных, сравнение, резюмирование или черновик.
- Оцените классификацию данных и выберите подходящий инструмент: облачный API с соглашением об обработке данных или локальную модель.
- Составьте инструкцию с явным описанием задачи, контекста, ограничений и формата вывода.
- Соберите контрольный набор документов с эталонными ответами для проверки качества.
- Проверьте модель на контрольном наборе, посчитайте точность по каждому полю или задаче.
- Настройте журналирование запросов и ответов для анализа ошибок.
- Внедрите обязательную проверку вывода человеком перед использованием результата в ответственных процессах.
- Ограничьте права сервиса, который выполняет действия по результатам вывода модели.
- Документируйте выбор инструмента, инструкции, процедуры проверки и реагирования на инциденты.
- Регулярно пересматривайте инструкции и метрики качества по мере накопления опыта.
Частые вопросы
Можно ли полностью автоматизировать обработку договоров с помощью нейросети?
Нет, полная автоматизация без проверки человеком не рекомендуется для ответственных задач. Модель может ошибаться, пропускать важные детали или добавлять информацию, которой нет в тексте. Вывод модели следует использовать как черновик или подсказку, которую проверяет и утверждает специалист.
Как выбрать между облачным API и локальной моделью?
Если документы содержат конфиденциальные данные, предпочтительна локальная модель или облачный сервис с соглашением об обработке данных и гарантией, что данные не используются для обучения. Облачный API проще в интеграции и не требует управления инфраструктурой, но передаёт данные за пределы вашей сети. Локальная модель сохраняет данные внутри периметра, но требует вычислительных ресурсов и настройки окружения.
Как улучшить точность извлечения данных?
Уточните инструкцию: добавьте примеры правильного вывода, явно укажите формат каждого поля, перечислите типичные ошибки и как их избежать. Проверьте модель на контрольном наборе, выявите систематические ошибки и скорректируйте инструкцию. Если документы сильно различаются по структуре, создайте отдельные инструкции для каждого типа.
Что делать, если модель добавляет информацию, которой нет в документе?
Добавьте в инструкцию явное ограничение: «Используй только информацию из текста документа. Не интерпретируй, не дополняй и не предполагай данные. Если информация отсутствует, верни null». Проверяйте вывод на контрольных примерах и отмечайте случаи галлюцинаций, чтобы улучшить инструкцию.
Как обрабатывать документы, которые не помещаются в контекст модели?
Разделите документ на логические фрагменты: главы, разделы или страницы. Обработайте каждый фрагмент отдельно и объедините результаты. Убедитесь, что деление не разрывает связанные пункты. Для задач резюмирования можно сначала резюмировать каждый фрагмент, а затем объединить резюме в итоговое.
Нужно ли обучать модель на собственных документах?
Для большинства задач достаточно хорошо составленной инструкции и примеров в запросе. Обучение или дообучение модели имеет смысл, если у вас есть большой размеченный набор документов и стандартная инструкция не даёт нужной точности. Обучение требует времени, данных и экспертизы, поэтому сначала попробуйте улучшить инструкцию.
Как защитить конфиденциальные данные при использовании облачного API?
Выберите провайдера с соглашением об обработке данных, гарантией хранения данных в нужном регионе и обязательством не использовать ваши запросы для обучения модели. Рассмотрите предварительную анонимизацию: замените имена, адреса и другие персональные идентификаторы на заглушки. Ограничьте круг сотрудников, имеющих доступ к API, и журналируйте все запросы.
Можно ли использовать модель для принятия юридически значимых решений?
Нет, вывод модели не является юридическим заключением и не должен использоваться для принятия решений без проверки квалифицированным специалистом. Модель помогает ускорить анализ и подготовить черновик, но окончательное решение принимает человек, несущий ответственность за результат.
Практический вывод
Языковые модели полезны для предварительного анализа документов, подготовки черновиков и извлечения структурированных данных. Успех зависит от чёткости инструкции, систематической проверки качества на контрольных примерах и обязательной проверки вывода человеком перед использованием в ответственных процессах. Защита конфиденциальных данных требует осознанного выбора инструмента, предварительной анонимизации или локального размещения модели, а также ограничения прав сервисов, которые выполняют действия по результатам вывода. При таком подходе нейросеть становится помощником, который ускоряет рутинные операции и позволяет специалисту сосредоточиться на задачах, требующих экспертизы и ответственности.