Лид: Как выбрать процесс, описать инструменты и ограничения, собрать прототип ИИ-агента и проверить его на реальных сценариях.
Дата проверки продуктовых сведений: 2026-09-16
Короткий ответ: Создание ИИ-агента начинается с выбора конкретной задачи и определения, нужна ли динамическая автономность или достаточно заранее заданного workflow. Затем вы описываете инструменты, определяете права доступа и ограничения, собираете прототип с помощью API языковой модели, тестируете на реальных сценариях и добавляете журналирование и проверку человеком для критичных действий.
Что такое ИИ-агент и нужен ли он вам
ИИ-агент — это система, в которой языковая модель динамически определяет, какие инструменты использовать, в каком порядке и с какими параметрами, чтобы достичь заданной цели. Это отличает агентов от заранее определённых рабочих процессов (workflows), где последовательность шагов и условия известны заранее.
Согласно рекомендациям Anthropic, стоит начинать с самого простого решения и добавлять агентность только когда есть измеримая польза. Если задачу можно решить фиксированным набором шагов — например, проверить базу данных, затем отправить уведомление — workflow будет предсказуемее и проще в отладке.
Агент имеет смысл, когда:
- невозможно заранее определить все варианты действий;
- нужно обрабатывать запросы с открытым контекстом;
- модель должна комбинировать несколько инструментов в зависимости от промежуточных результатов.
Если ваша задача укладывается в схему «если A, то B, иначе C», начните с обычного скрипта или workflow-платформы. Агентность добавляет сложность, которая должна быть оправдана практической выгодой.
Выбор задачи и границ ответственности
Прежде чем писать код, сформулируйте задачу в виде конкретного результата и списка ограничений. Например:
- Агент отвечает на вопросы клиентов, используя базу знаний и данные заказов.
- Агент может только читать данные заказов, но не изменять их.
- Агент не может инициировать возврат средств без подтверждения человека.
Этот шаг определяет набор инструментов, права доступа и способ проверки результата. Чем точнее вы опишете границы, тем проще будет защитить систему от непредвиденных действий и оценить качество работы агента.
OWASP Top 10 для приложений с LLM выделяет избыточную автономность как один из ключевых рисков: если агент может выполнять привилегированные действия без проверки, вывод модели становится точкой атаки.
Описание инструментов и прав доступа
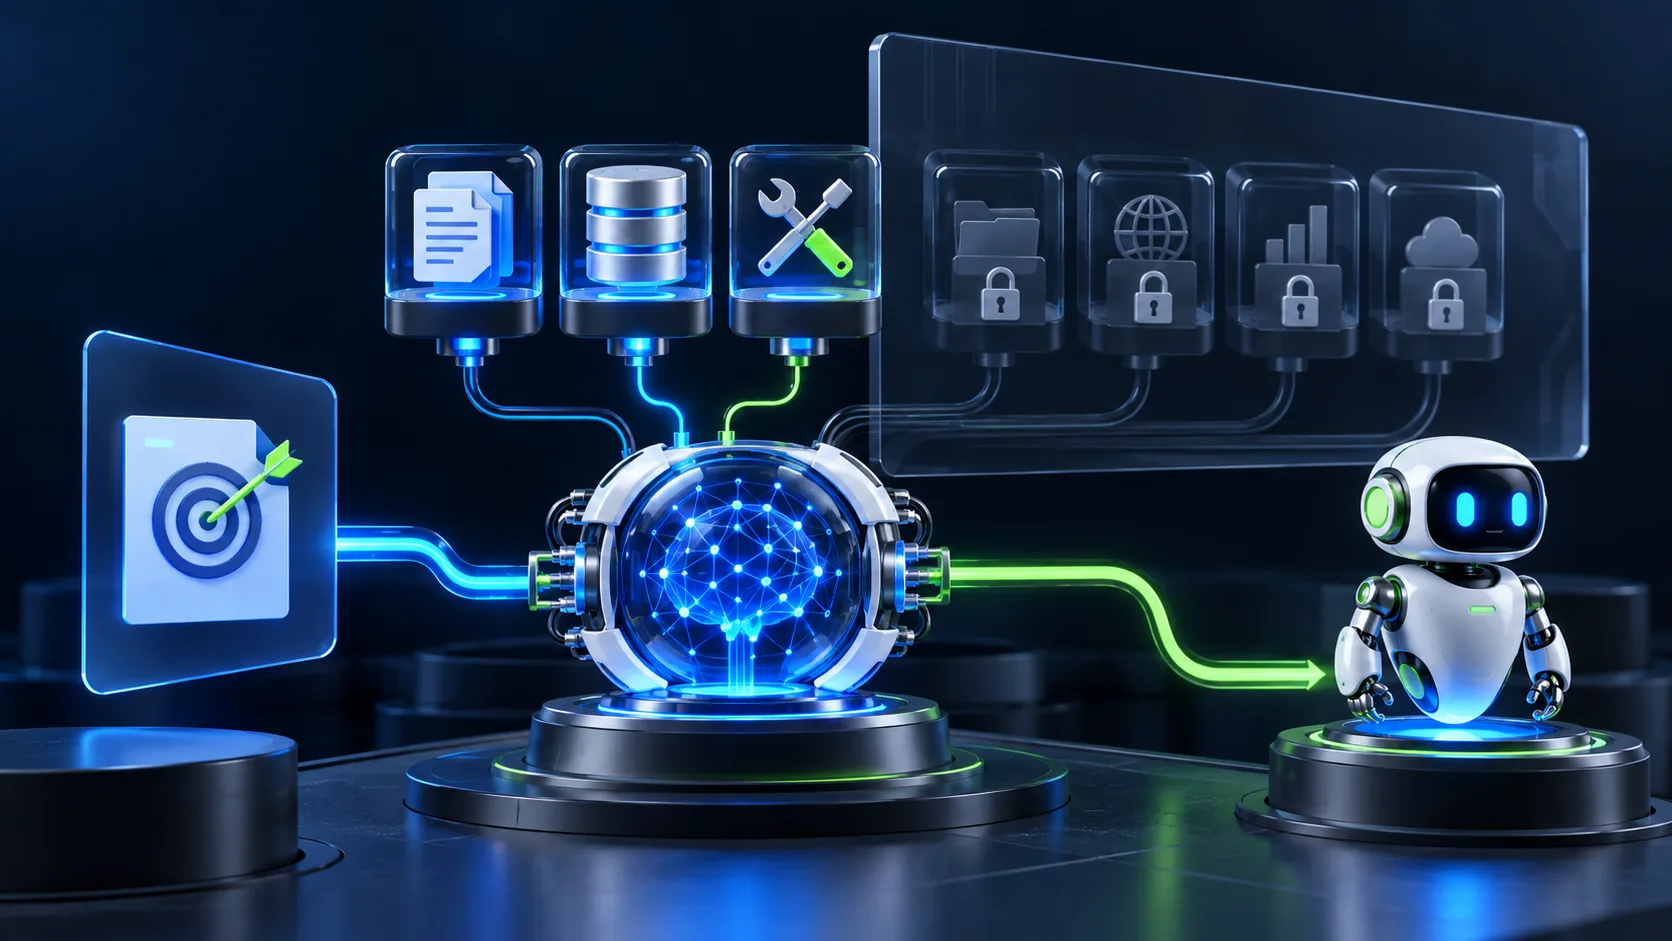
Инструменты — это функции, которые модель может вызывать для получения данных или выполнения действий. Согласно документации OpenAI, набор инструментов и права должны соответствовать конкретной задаче.
Для каждого инструмента опишите:
- имя и назначение (например,
search_knowledge_base); - обязательные и опциональные параметры;
- формат входных данных и тип возвращаемого значения;
- права доступа (только чтение, изменение, удаление);
- допустимые источники данных (внутренняя база, внешний API, файловая система).
Пример описания инструмента в формате JSON Schema:
{
  "name": "get_order_status",
  "description": "Возвращает статус заказа по номеру",
  "parameters": {
    "type": "object",
    "properties": {
      "order_id": {
        "type": "string",
        "description": "Уникальный номер заказа"
      }
    },
    "required": ["order_id"]
  }
}
Модель получает это описание в контексте и выбирает инструмент, когда пользовательский запрос требует данных о заказе. Важно не предоставлять модели больше инструментов, чем требуется: лишние функции увеличивают вероятность ошибочного выбора и расширяют поверхность атаки.
Сборка прототипа с помощью API языковой модели
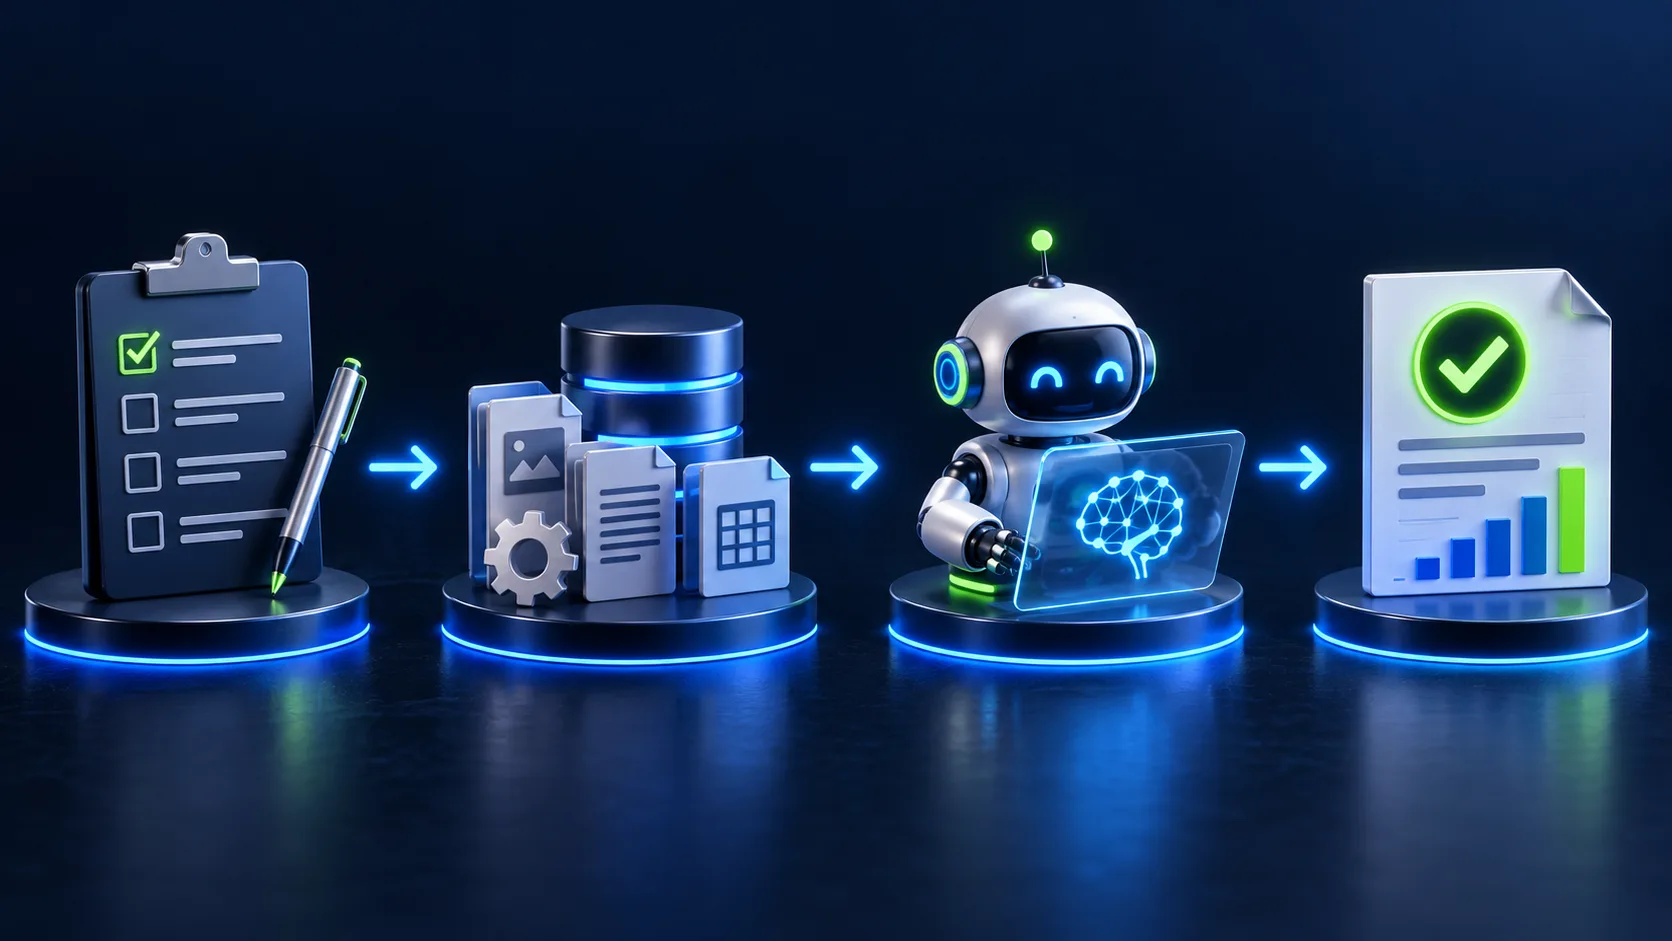
Большинство современных API предоставляет механизм вызова функций (function calling или tool use). Общий алгоритм выглядит так:
- Вы отправляете модели пользовательский запрос и список доступных инструментов.
- Модель возвращает либо текстовый ответ, либо запрос на вызов инструмента с параметрами.
- Ваш код выполняет вызов инструмента и передаёт результат обратно модели.
- Модель анализирует результат и продолжает диалог или вызывает следующий инструмент.
Pseudocode на Python:
messages = [{"role": "user", "content": user_query}]
tools = [get_order_status_definition, search_knowledge_base_definition]

while True:
    response = api_client.chat(messages=messages, tools=tools)

    if response.finish_reason == "stop":
        # Модель готова ответить пользователю
        return response.content

    if response.finish_reason == "tool_calls":
        for tool_call in response.tool_calls:
            result = execute_tool(tool_call.name, tool_call.arguments)
            messages.append({
                "role": "tool",
                "tool_call_id": tool_call.id,
                "content": result
            })
        # Отправить результаты обратно модели
        continue
Этот цикл формирует базовый агентный рабочий процесс: модель сама определяет последовательность вызовов и останавливается, когда получает достаточно данных для ответа.
Добавление журналирования и проверки человеком
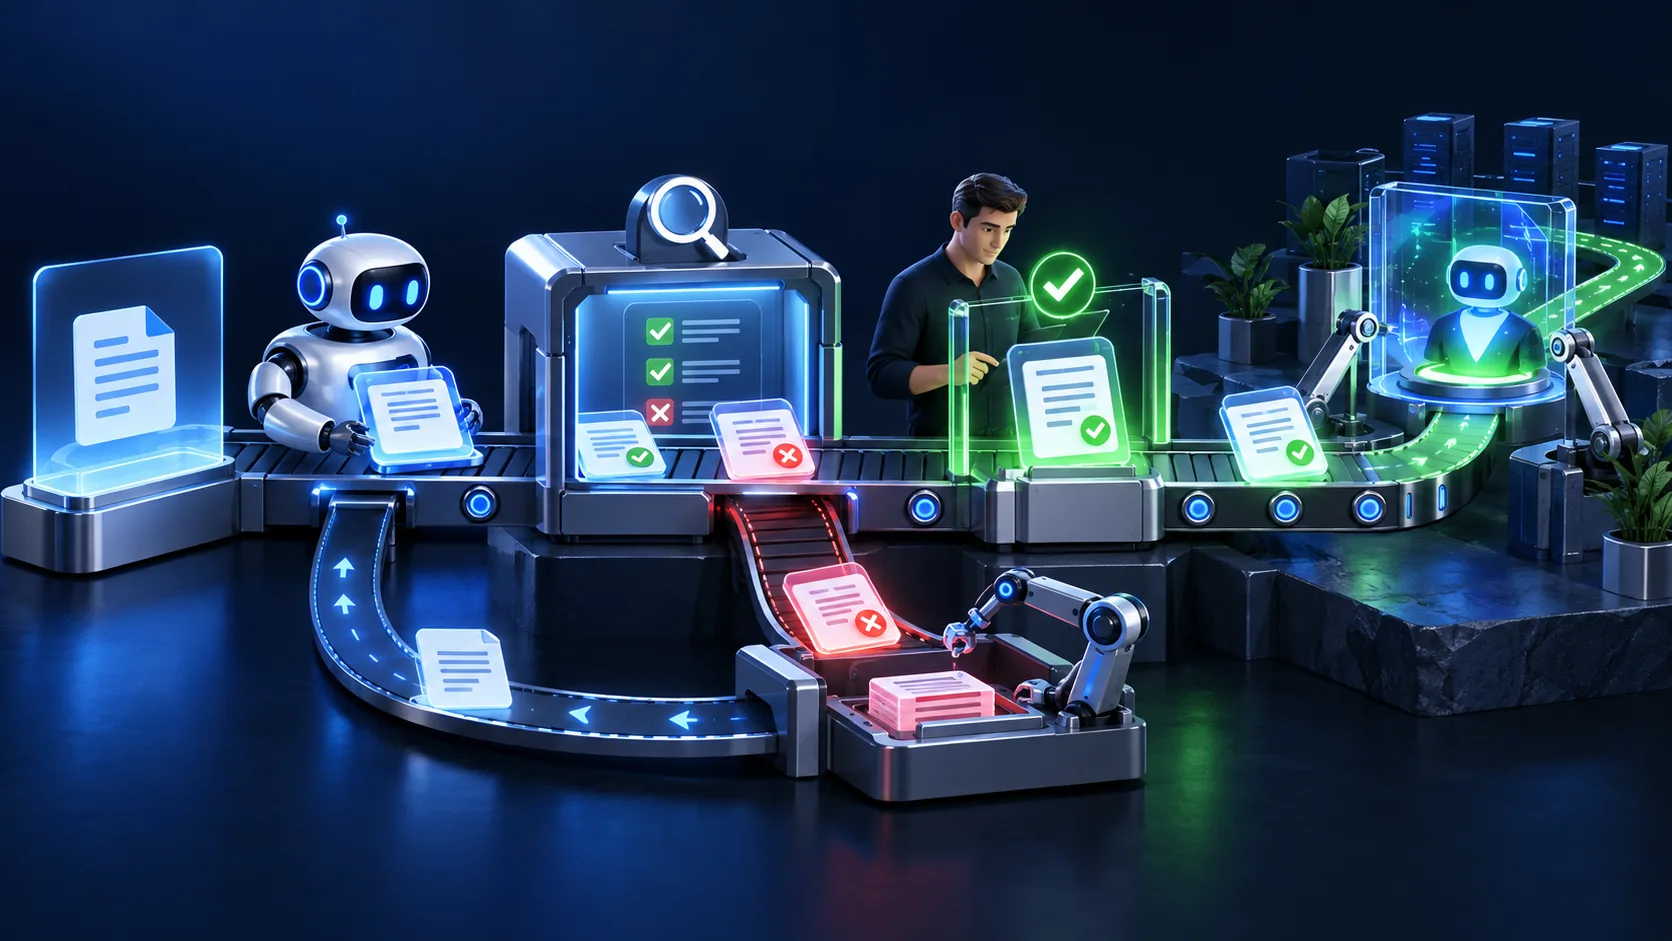
Вывод языковой модели нельзя считать доверенным вводом для привилегированных действий. OWASP рекомендует обрабатывать вывод как потенциально небезопасный и применять валидацию перед выполнением критичных операций.
Практические меры:
- Журналируйте каждый вызов инструмента: имя, параметры, результат, временную метку.
- Добавьте проверку человеком (human-in-the-loop) для действий с необратимыми последствиями: удаление данных, отправка платежей, изменение настроек безопасности.
- Используйте белые списки допустимых значений параметров, если это возможно.
- Ограничьте максимальное количество вызовов инструментов в одной сессии, чтобы предотвратить зацикливание.
Пример проверки перед выполнением:
def execute_tool(name, arguments):
    log_tool_call(name, arguments)

    if name in PRIVILEGED_TOOLS:
        approval = request_human_approval(name, arguments)
        if not approval:
            return {"error": "Action requires human approval"}

    if name == "delete_record":
        if not is_valid_record_id(arguments["record_id"]):
            return {"error": "Invalid record ID"}

    return actual_tool_execution(name, arguments)
Журналирование даёт возможность анализировать поведение агента, выявлять ошибочные цепочки вызовов и улучшать описания инструментов.
Тестирование на реальных сценариях
Прототип нужно проверить на наборе типичных и граничных сценариев. Подготовьте список запросов, которые покрывают:
- успешный путь: запрос, который должен быть решён одним или несколькими вызовами инструментов;
- отсутствие данных: запрос, для которого инструменты не возвращают результата;
- неоднозначность: запрос, который можно интерпретировать по-разному;
- недопустимое действие: запрос, требующий инструмента, к которому у агента нет доступа.
Для каждого сценария зафиксируйте:
- какие инструменты были вызваны и в каком порядке;
- соответствует ли итоговый ответ ожиданиям;
- были ли попытки вызвать недоступные инструменты;
- насколько понятен ответ пользователю.
Не придумывайте процентов успешных тестов — фиксируйте конкретные результаты по каждому сценарию. Например: «Сценарий 3: модель вызвала инструмент search_knowledge_base с корректным запросом, получила пустой результат и сообщила пользователю, что информация отсутствует».
Типичные ошибки при создании ИИ-агентов
На этапе прототипирования часто встречаются следующие проблемы:
- Слишком много инструментов: модель выбирает неправильный инструмент или комбинацию, потому что описания пересекаются.
- Неточные описания: если описание инструмента не объясняет, когда его использовать, модель вызывает его в неподходящий момент.
- Отсутствие ограничений на количество итераций: агент может зациклиться, вызывая один инструмент за другим без продвижения к цели.
- Игнорирование прав доступа: если агент может вызвать любую функцию, случайная или намеренная инъекция в запросе может привести к утечке данных или нежелательным изменениям.
- Отсутствие fallback-логики: если все инструменты вернули ошибку, модель должна уметь объяснить это пользователю, а не зависнуть.
Anthropic рекомендует начинать с минимального набора инструментов и добавлять новые только после того, как измерена польза: это снижает сложность отладки и делает поведение агента более предсказуемым.
Безопасность и управление рисками
NIST AI Risk Management Framework предлагает добровольный подход к управлению рисками на этапах проектирования, разработки, использования и оценки систем ИИ. Профиль для генеративного ИИ включает действия по четырём функциям: govern (управление), map (картирование рисков), measure (измерение) и manage (управление рисками).
Практические рекомендации для ИИ-агентов:
- Govern: определите владельца процесса, порядок утверждения изменений в наборе инструментов и процедуру реагирования на инциденты.
- Map: составьте список рисков для каждого инструмента (утечка данных, изменение критичных настроек, DoS) и определите вероятность и последствия.
- Measure: отслеживайте частоту вызовов каждого инструмента, долю успешных и неудачных вызовов, количество запросов на проверку человеком.
- Manage: внедрите технические меры (белые списки, rate limiting, human-in-the-loop) и организационные (обучение команды, регулярный пересмотр прав доступа).
OWASP особо отмечает prompt injection — попытку изменить поведение модели через пользовательский ввод. Если агент обрабатывает данные из недоверенных источников (например, текст с внешних сайтов), разделяйте инструкции системы и пользовательский контент, используйте отдельные роли сообщений и валидируйте параметры инструментов независимо от модели.
Чек-лист перед запуском прототипа
| Пункт | Проверено |
|---|---|
| Задача и границы ответственности сформулированы письменно | ☐ |
| Для каждого инструмента определены права доступа (чтение/запись/удаление) | ☐ |
| Описания инструментов содержат примеры использования | ☐ |
| Критичные действия требуют подтверждения человека | ☐ |
| Все вызовы инструментов журналируются с временными метками | ☐ |
| Установлен лимит на количество итераций агента в одной сессии | ☐ |
| Подготовлен набор тестовых сценариев (успешные, граничные, недопустимые) | ☐ |
| Определён порядок реагирования на инциденты безопасности | ☐ |
| Параметры инструментов проверяются независимо от вывода модели | ☐ |
| Агент умеет сообщить пользователю, что задача не может быть выполнена | ☐ |
Как улучшать агента после первых тестов
После запуска прототипа на ограниченной аудитории собирайте обратную связь и метрики:
- Какие запросы пользователей остались без ответа или получили неверный ответ.
- Какие инструменты вызываются чаще всего и насколько часто они возвращают ошибки.
- Сколько действий потребовали вмешательства человека и по какой причине.
- Есть ли цепочки вызовов, которые повторяются и могли бы быть заменены одним специализированным инструментом.
На основе этих данных можно:
- Уточнить описания инструментов, добавив примеры запросов, для которых инструмент подходит или не подходит.
- Разделить многофункциональный инструмент на несколько узких, чтобы модель точнее выбирала нужный.
- Добавить новый инструмент, если обнаружился повторяющийся сценарий, который текущий набор не покрывает.
- Убрать редко используемый инструмент, если он создаёт путаницу.
Не забывайте обновлять тестовые сценарии: каждая обнаруженная ошибка должна превратиться в автоматический тест, чтобы убедиться, что проблема не вернётся после изменений.
Часто задаваемые вопросы
Можно ли использовать агента без API ключа?
Нет, для вызова языковой модели требуется доступ к API провайдера. Вы можете развернуть открытую модель локально, но это потребует вычислительных ресурсов и навыков настройки инференса.
Как ограничить стоимость работы агента?
Установите лимит на количество вызовов модели в одной сессии, ограничьте длину контекста и используйте кеширование результатов инструментов, если запросы повторяются. Проверяйте актуальные тарифы провайдера (по состоянию на 2026-09-16) и настройте уведомления о превышении бюджета.
Что делать, если агент зацикливается?
Добавьте счётчик итераций и прерывайте выполнение, если лимит превышен. Проанализируйте журнал вызовов: возможно, описание инструмента вводит модель в заблуждение, и она пытается получить данные повторно.
Нужно ли хранить всю историю диалога?
Это зависит от задачи. Если агент должен помнить контекст в рамках сессии — передавайте всю историю. Если каждый запрос независим — достаточно текущего сообщения и результатов инструментов. Длинная история увеличивает стоимость вызова и может превысить лимит контекста модели.
Можно ли комбинировать агента и заранее заданный workflow?
Да, и это часто оптимальный подход. Используйте workflow для предсказуемых шагов (аутентификация, проверка прав, валидация) и передавайте управление агенту только для части задачи, где требуется динамический выбор инструментов.
Как проверить, что агент не раскрывает чувствительные данные?
Ограничьте доступ инструментов только к необходимым полям данных. Журналируйте все ответы модели и регулярно проверяйте выборку на наличие персональных данных, внутренних идентификаторов или конфиденциальной информации. Используйте redaction-библиотеки для автоматической маскировки чувствительных полей перед передачей данных модели.
Практический вывод
Создание ИИ-агента — это итеративный процесс: вы начинаете с минимального набора инструментов, тестируете на реальных запросах, журналируете вызовы и добавляете проверки для критичных действий. Не стремитесь сразу автоматизировать весь процесс: начните с прототипа, где агент предлагает варианты, а человек принимает решение. По мере накопления данных о поведении системы вы сможете расширить автономность там, где это безопасно и измеримо полезно. Документируйте права доступа каждого инструмента, регулярно пересматривайте журналы вызовов и помните, что вывод языковой модели — это рекомендация, а не доверенная команда.